Une page peut être excellente et recevoir de bons liens. Si Googlebot ne peut pas la découvrir, si une balise canonique désigne une autre URL ou si le rendu JavaScript masque son contenu, son potentiel reste limité. Le SEO technique réduit ces obstacles avant qu’ils ne deviennent des pertes de trafic, de demandes ou de chiffre d’affaires.
Que recouvre le SEO technique ?
Le SEO technique couvre l’exploration, l’indexation, l’architecture, les performances, le rendu mobile, les données structurées et la gestion des doublons. Il ne remplace ni un contenu utile ni l’autorité externe. Il permet aux moteurs d’attribuer ces signaux à la bonne URL.
La distinction est simple : le contenu explique le sujet d’une page, les liens externes contribuent à sa crédibilité et la technique garantit que le moteur peut y accéder et l’interpréter. Ces disciplines se renforcent mutuellement.
Pourquoi ces fondations influencent-elles les résultats ?
Un problème technique se manifeste souvent d’abord comme un problème commercial. De nouvelles pages ne sont pas indexées. Plusieurs variantes d’un produit se concurrencent. Une refonte fait chuter les positions faute de redirections. Un formulaire lent ou instable décourage les prospects.
Conséquences habituelles
Les conséquences les plus courantes sont concrètes :
- une mauvaise explorabilité empêche la découverte d’URL importantes
- une directive noindex ou une canonique incohérente bloque leur présence dans les résultats
- les doublons dispersent les signaux entre plusieurs adresses
- les erreurs 404 et les chaînes de redirections interrompent les parcours
- des modèles lents dégradent l’expérience sur toutes les pages qui les utilisent.
Il faut donc traiter la technique tôt dans une stratégie SEO. Publier davantage sur une base instable augmente parfois le nombre de problèmes au lieu d’augmenter la visibilité.
Les principaux domaines du SEO technique
Exploration et fichier robots.txt
L’exploration désigne la capacité d’un robot à découvrir et demander une URL. Les liens HTML, la navigation, les sitemaps et la disponibilité du serveur influencent ce processus.
Le fichier robots.txt gère les requêtes des robots, mais ne constitue pas une méthode fiable de désindexation. Une URL bloquée peut encore être connue par d’autres signaux. Il faut vérifier que les pages utiles ne sont pas bloquées et maîtriser les espaces infinis créés par les filtres, les recherches internes ou les paramètres.
Indexation et sitemap XML
Une page explorée n’est pas automatiquement indexée. Google peut l’écarter s’il détecte une faible valeur, un doublon, une canonique contradictoire ou un problème de rendu.
Le sitemap XML fournit une liste propre des URL canoniques à indexer. Il ne garantit pas leur classement. Il doit exclure les redirections, les erreurs, les pages noindex et les variantes dupliquées. La comparaison entre URL du sitemap et données d’indexation de Search Console révèle souvent les écarts les plus utiles.
Architecture et maillage interne
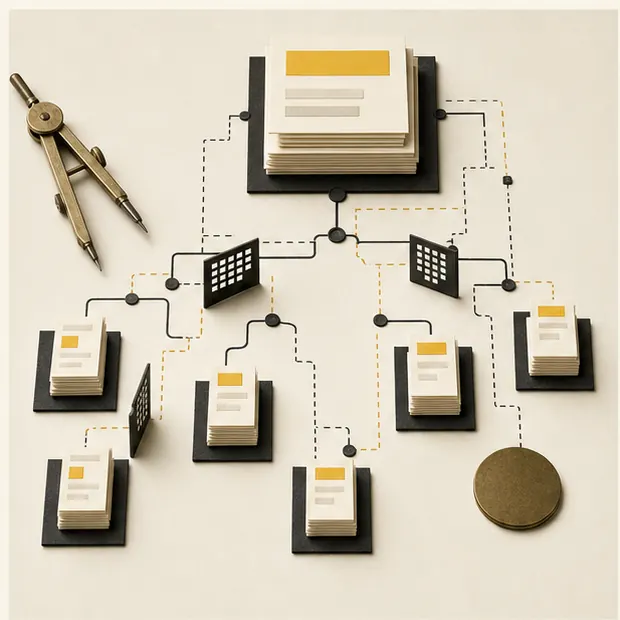
L’architecture organise la circulation du contexte et de l’autorité. Une page commerciale importante ne devrait pas être isolée à six clics de l’accueil. Elle doit recevoir des liens descriptifs depuis la navigation ou des contenus pertinents.
Des URL lisibles, des fils d’Ariane et une hiérarchie stable aident les utilisateurs comme les moteurs. Il faut repérer les pages orphelines, les ancres vagues et les sections accessibles uniquement après une interaction JavaScript.
Balises canoniques et contenus dupliqués
Une balise canonique indique la version préférée parmi plusieurs pages proches. C’est un signal, pas un ordre. Google peut l’ignorer si les liens internes, le sitemap, les redirections et le contenu envoient des signaux contradictoires.
Les pages indexables utilisent généralement une canonique autoréférente. Les variantes de suivi, d’impression ou de filtre peuvent pointer vers l’URL principale lorsqu’elles répondent au même besoin. Deux pages visant des intentions différentes ne doivent pas être fusionnées artificiellement.
Codes HTTP, redirections et pages cassées
Une URL valide renvoie normalement un code 200. Une suppression définitive renvoie 404 ou 410, sauf lorsqu’un remplacement réellement pertinent justifie une redirection permanente. Rediriger toutes les anciennes pages vers l’accueil crée de la confusion et ne préserve pas automatiquement leur valeur.
Les chaînes et boucles ralentissent les utilisateurs et compliquent le traitement des signaux. Après une migration, les anciennes URL doivent pointer directement vers leur équivalent final, tandis que les liens internes doivent déjà utiliser les nouvelles adresses.
Vitesse et Core Web Vitals
Les Core Web Vitals mesurent le chargement, la réactivité et la stabilité visuelle à travers le LCP, l’INP et le CLS. Le bon objectif n’est pas un score parfait sur l’accueil, mais une expérience satisfaisante sur les modèles qui génèrent du trafic et des conversions.
Les gains viennent souvent du redimensionnement des images, de la réduction du JavaScript inutilisé, d’un meilleur cache et de dimensions réservées aux éléments tardifs. Les données réelles de Search Console complètent les tests de laboratoire de PageSpeed Insights.
Mobile et rendu JavaScript
Google utilise principalement la version mobile pour l’indexation. Le contenu, les liens et les données structurées importants doivent donc rester présents et accessibles sur mobile.
Un site JavaScript peut être indexé, mais ajoute des points de défaillance. Le HTML initial peut être vide, les routes peuvent ne pas produire de vrais liens et une API bloquée peut supprimer le contenu rendu. Pour les modèles essentiels, le rendu côté serveur ou la génération statique offre souvent une base plus robuste.
Consultant SEO indépendant et ancien développeur front-end. Plus de huit ans d’expérience et plus de 50 clients au Royaume-Uni et en Europe.